 meirlabs
 מאיר רוזנשיין
איך שומרים על נכסי מותג ומסקוטים מ‑AI עקביים לאורך קמפיין?
מפסיקים לתאר את הדמות במילים ומצרפים אותה כתמונה. כל יצירה מקבלת את תמונת העוגן עצמה ועוד הוראה אחת: אותה דמות, רק בתנוחה חדשה. הזהות יושבת בפיקסלים, לא בטקסט. מהעוגן בונים ערכה של תנוחות מאושרות, בוחרים אחת לכל פריט, ומניחים את הכותרות ב‑HTML מעל האיור. אצל Lottie, המסקוט של soclever, זה החזיק אקסולוטל אחד יציב לאורך 48 קובצי מודעה מוכנים להעלאה.מבצע השקה: לקוחות ראשונים מקבלים 50% הנחה על הבנייה הראשונה. בפועל: בערך חצי מהמספרים האלה. קבעו תוכנית AI חינם וההנחה נשמרת לכם.
רוב המייסדים חושבים שבעיית המסקוט היא בעיה של ניסוח פרומפט. תיאור מדויק מספיק, הם חושבים, והמודל יצייר את אותה דמות בכל פעם. הבעיה לא שם. ל"אקסולוטל בגוון אפרסק-זהב עם ציציות זימים נוצתיות" יש אלף פרצופים, והמודל בוחר אחד חדש בכל קריאה. משפט טוב יותר לא פותר את זה. הוא רק מצמצם את הניחוש.
למה אותו פרומפט נותן לכם דמות אחרת בכל פעם?
כי תיאור במילים מבקש מהמודל להמציא את הדמות מאפס בכל יצירה, ובכל פעם ברירות המחדל שלו עלולות להיכנס. הפרופורציות זזות, הפלטה מתחממת או מתקררת, הסגנון נסחף. אתם לא מבקשים את אותו אקסולוטל פעמיים. אתם מבקשים פעמיים את הניחוש הכי טוב של המודל למילים שלכם, והניחושים לא זהים. מילים מקבעות ז'אנר ("אקסולוטל מצויר וידידותי"). דמות מסוימת הן לא מקבעות. בשביל זה צריך לצרף את הדמות עצמה.
איך נועלים את הדמות?
מצרפים את תמונת העוגן עצמה לבקשה, לפני הטקסט, והיא נושאת את הזהות. הפרומפט אומר רק מה שונה הפעם. אצל soclever, ספר הכללים הפנימי שמנהל כל יצירה של Lottie קובע את זה בשלושה כללים:
- תמונת הייחוס מצורפת תמיד. הזהות יושבת בתמונה, לא בטקסט.
- המראה לא מוקלד מחדש בטקסט, אף פעם. במילים של הספר: "Text competing with the reference is the #1 cause of drift" (טקסט שמתחרה בתמונת הייחוס הוא הגורם מספר 1 לסחף).
- שינוי אחד בכל קריאה. לא משלבים תנוחה, אביזר ומצב רוח בבת אחת.
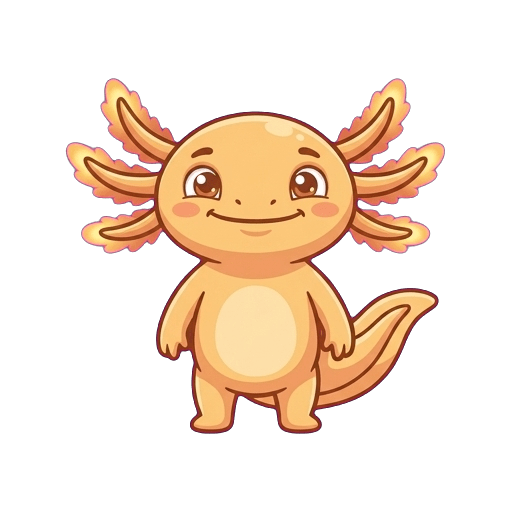
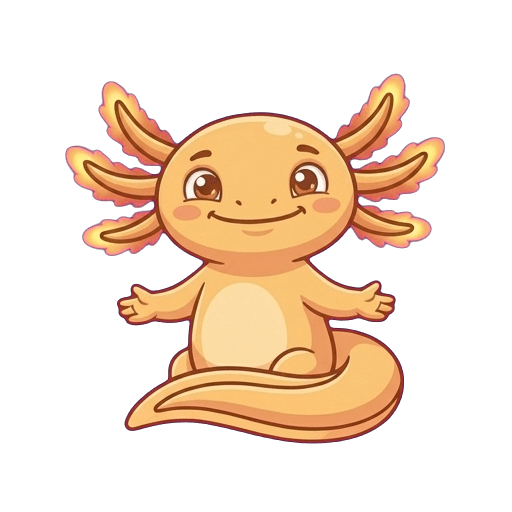
ההוראה שבאמת חשובה בפרומפט היא זו: "Keep the mascot's identity (colors, face, proportions) EXACTLY consistent with the attached reference image. It is the same character, just re-posed" (שמרו על זהות המסקוט, הצבעים, הפנים והפרופורציות, בדיוק כמו בתמונת הייחוס המצורפת; זו אותה דמות, רק בתנוחה חדשה). מה שחשוב זה מה שהיא לא עושה. היא לא חוזרת על הצבעים או על הצורה של Lottie. היא קובעת רק שכל מה שבתמונה המצורפת נשאר, ומוסרת למודל את הדבר היחיד שמותר לו לשנות: התנוחה. התמונה למטה נוצרה בדיוק כך, מהעוגן שלמעלה.
איך מגוונים בלי שהדמות תיסחף?
בונים ערכה. מהעוגן האחד יוצרים סט של מצבי רוח ופרסונות מאושרים: מאמנת, פרופסורית, סיירת. כל אחת מהן הופכת לתמונת ייחוס בפני עצמה, וכולן חוזרות לאותה זהות נעולה. אחר כך בוחרים תמונת ייחוס לכל פריט, כדי שהטון הנכון ייכנס לפני שהמודל קורא מילה מהבריף. בקמפיין המודעות של soclever לשישה קורסים בחרו תנוחה לכל קורס ביד:
"Teach a kid who's given up"   ->  coach pose    (סבלנית, יושבת נמוך)
"Grow your tutoring business"  ->  focused pose
"Understand medical results"   ->  encouraging pose
"Spot fake news"               ->  scout pose
"Master Excel"                 ->  professor pose (משקפיים, ספר)
"Build a portfolio"            ->  plain 3/4 anchor
זה גיוון מכוון, לא סחף: בחירה מבין תנוחות שאושרו מראש, והדמות שמתחת לא משתנה. מה שמחזיק אותה שם הוא סט של כללי הגנה, כל אחד נכתב אחרי כישלון אמיתי:
- ציציות הזימים נסחפות לארגמן. סצנות חמות משכו את ציציות הזהב של Lottie לאדום, כדי להתאים לפלטה. התיקון: כלל קבוע שהציציות "must stay the mascot's natural warm gold/peach/orange exactly as in the reference image, NEVER crimson, red, or recolored to match the scene palette" (חייבות להישאר בזהב/אפרסק/כתום החמים הטבעיים של המסקוט, בדיוק כמו בתמונת הייחוס, לעולם לא ארגמן, אדום, או צבועות מחדש לפי פלטת הסצנה).
- המסקוט מתעוות כשצריך להקטין אותו. המודל פישט את הפרופורציות במקום להקטין. התיקון: "If the mascot needs to appear smaller in the frame, scale it down; never recolor it" (אם המסקוט צריך להיראות קטן יותר בפריים, מקטינים אותו; אף פעם לא צובעים אותו מחדש).
- דמות אנושית שנכנסת לסצנה במקרה. התיקון: "NO real human figures, faces, or photographic people anywhere" (בלי דמויות אנושיות אמיתיות, פנים או אנשים מצולמים, בשום מקום), כך שהאקסולוטל נשאר הפרצוף היחיד במותג.
למה להשאיר כל מילה מחוץ לאיור?
כי מודלי תמונה לא יודעים לצייר טקסט קריא, וטקסט שצרוב בתמונה אי אפשר לסדר מחדש או לערוך בלי לשלם על יצירה חדשה. לכן האיור נוצר עם איסור גורף: "ABSOLUTELY NO text, words, letters, numbers, labels, captions, signage, or speech bubbles anywhere in the image" (בלי שום טקסט, מילים, אותיות, מספרים, תוויות, כיתובים, שילוט או בועות דיבור בשום מקום בתמונה). כל כותרת, תווית ולוגו מונחים אחר כך מעל, כטקסט HTML אמיתי, חד בכל גודל. הפיצול הזה נותן שלושה דברים: טיפוגרפיה מדויקת לפיקסל בכל שפה, איור מקור אחד שמסודר מחדש בגודל של כל פורמט, וחופש לנסח מחדש כותרת בלי ליצור מחדש פיקסל אחד של איור.
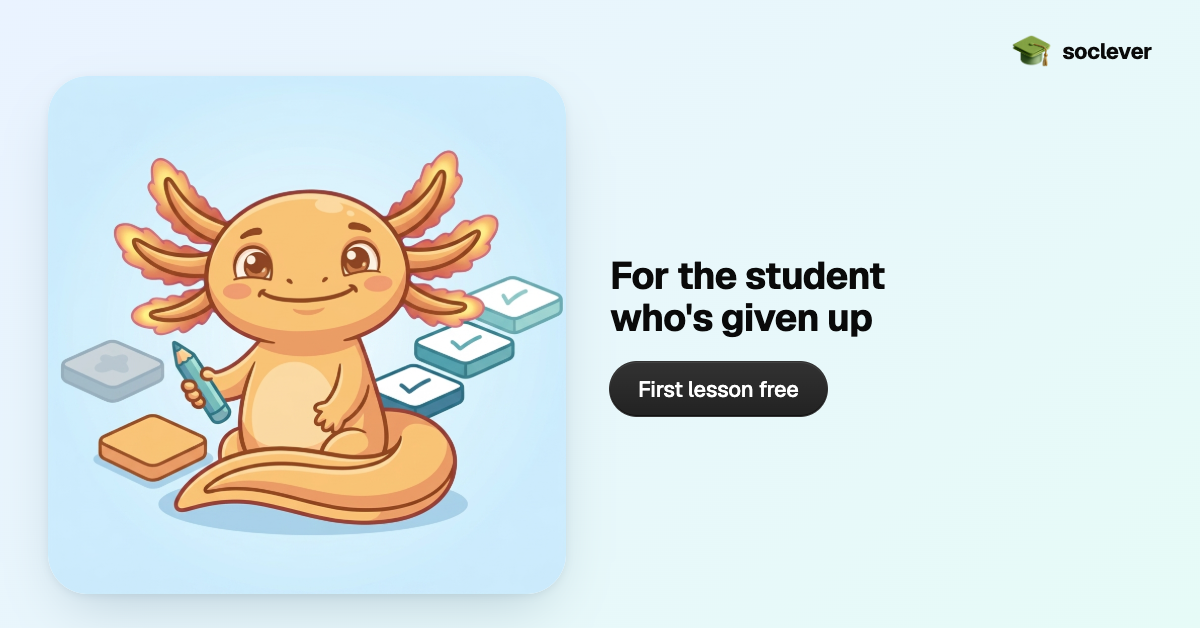
וכל פלטפורמה מקבלת את הגודל שלה, בלי חיתוך. LinkedIn רוצה 1200 על 627, X רוצה 1200 על 675, Meta רוצה 1200 על 628. כולם "לרוחב עם עמודת טקסט", אבל שונים בכמה פיקסלים. חותכים תמונת מאסטר אחת לשלושתם? המסקוט או הכותרת נחתכים אחרת בכל אחד. במקום זה, איור ריבועי אחד מסודר מחדש לשבעה קנבסים מדויקים, ואיור אחד משמש פעמיים. ככה שישה קורסים הפכו ל‑48 קבצים מוכנים להעלאה. מלכודת אחת ששווה לדעת מראש: כשמכניסים איור ריבועי למסגרת לא ריבועית, קובעים למכל יחס גובה-רוחב קבוע, אחרת מקבלים פסים לבנים מעל ומתחת לאיור.
מה זה לא פותר?
שיטת תמונת הייחוס מחזיקה דמות סטטית יציבה. אנימציה או מודל תלת-ממד עם שלד היא לא נותנת. היא גם לא מבטיחה זהות פיקסל-אחר-פיקסל: הבעות וזוויות עדיין זזות קצת, ובדיוק בגלל זה אדם מאשר כל תנוחה לפני שהיא נכנסת לערכה כתמונת ייחוס. וזה עובד רק על מודל שמקבל תמונה כקלט (soclever מריצה את מודל התמונה של Gemini בערך ב‑$0.067 לתמונה). מה שמקבלים הוא לא שיבוט בכל קריאה. זו אותה דמות מזוהה, בכל פעם, ב‑$0.067 לתמונה. לנעול דמות לערכת ייחוס זה בנייה סביב תהליך עבודה אחד, כמו כל פרויקט אימוץ AI אחר: היקף צר, עולה לאוויר, ומשמש שוב בכל קמפיין שאחריו.